MCP 让智能体调用外部工具,但很多场景不希望数据出内网——代码库、客户资料、内部文档都是敏感资产。把 MCP Server 接到本地大模型(如 Ollama 跑的 Qwen 、 Llama),就能在完全离线的环境里让智能体既懂上下文又能调工具。关于怎么把 Ollama 这类开放模型装进内网,可先看 本地部署大模型怎么做。本文讲清 MCP 与本地模型打通的架构、最小配置与常见坑。
为什么要把 MCP 接本地大模型
云端旗舰模型能力最强,但每发一条带内部数据的请求,都可能把敏感信息送到第三方。对金融、医疗、企业内部系统这类场景,数据不出本机是硬要求。 Ollama 这类本地推理运行时让 7B~70B 级的开放模型跑在你的机器或内网服务器上,再配合 MCP,智能体既能读取本地资源、调用本地工具,又不触网。代价是模型对工具调用的遵循度不如云端,需要更多兜底。
架构:Ollama + MCP 客户端 + 工具服务
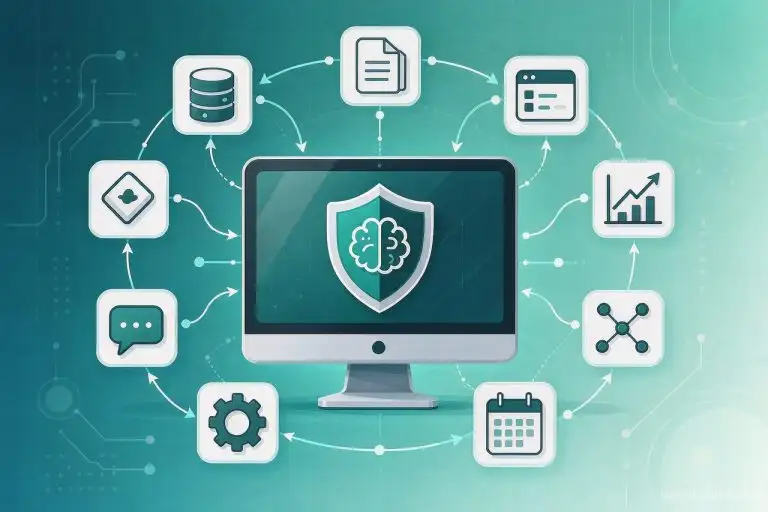
三层结构:最底层是 Ollama 提供模型推理;中间是支持 MCP 的客户端(或你自写的桥接层),负责把模型的 tool_call 意图翻译成对 MCP Server 的调用;最上层是一个或多个 stdio/HTTP 型 MCP Server,暴露具体工具(读文件、查数据库、调内部 API)。三者都在内网,数据全程不离开边界。关于 MCP 的基本盘,建议先读 MCP 是什么入门教程。
最小跑通:本地起一个 MCP Server
用官方 SDK(TypeScript 或 Python)写一个最简单的 stdio 型服务:定义一个工具,比如「列出某目录下文件」,给出名称和输入 schema,实现处理函数。启动后它会在标准输入输出上和客户端通信。想从零搭一个可用服务,MCP Server 自己搭建教程 给了 10 分钟上手的完整路径。
让 Ollama 模型学会用工具
不是所有本地模型都支持 function calling 。优先选明确标注支持工具调用的模型(如 qwen2.5 、 llama3.1 系列),并在请求里带上工具定义。客户端拿到模型的 tool_call 后,转发给对应 MCP Server,把返回再喂回模型完成一轮。传输层若走网络,记得对照 MCP 传输方式对比 选好 stdio 还是 HTTP 。
权限与隔离:别让本地模型越权
本地部署不等于安全。模型能调什么工具、能访问哪个目录,都要显式白名单化。一个「读文件」工具若不加路径限制,模型可能把整个磁盘翻一遍。把工具收敛到最小必要集合,并在工具层做路径/端口校验,比依赖模型自觉可靠得多。
- 装运行时:本地装 Ollama 并拉取一个支持工具调用的模型,如 qwen2.5 或 llama3.1 。
- 起 MCP Server:用官方 SDK 写一个 stdio 型服务,只暴露必要工具。
- 配客户端:在支持 MCP 的客户端或自写桥接里登记 server 的命令与参数。
- 联调:用自然语言触发工具,确认模型能产出正确的 tool_call 并拿到结果。
- 收紧权限:把工具限制在白名单目录与端口,禁止模型访问无关资源。
常见坑
- 模型不支持工具:拉错镜像或版本,模型根本不产出 tool_call,表现为「直接说话不调工具」,换对模型即可。
- stdio 环境变量没传:MCP Server 依赖的令牌或路径若只在 shell 里,客户端启动时没继承就会连不上。
- 本地端口暴露:HTTP 型 MCP 若绑了 0.0.0.0 又没鉴权,等于把工具敞开在内网,务必限制监听地址与加鉴权。
把 MCP 接上本地大模型,是在「能力」和「数据主权」之间取的一个务实平衡点。它让离线环境也能拥有会调工具的智能体,而代价——模型遵循度与运维——可以通过选对模型和加校验来摊薄。对想进一步私有化整条链路的团队,这个架构是绕不开的一块基石。
常见问题
本地模型都能用 MCP 吗?
私有化 MCP 比云端慢很多吗?
数据真的完全不出内网吗?
本地模型调工具不稳定怎么办?
评论 (0)