一句话答案:GraphRAG 不是「用图数据库存向量」,而是先用大模型从语料里抽取实体与关系建成知识图谱,再用 Leiden 之类的社区发现算法把图谱切成分层社区,为每个社区预先生成摘要;回答全局性问题时,并行让每个社区各答一部分,最后汇总成最终答案。它解决的是普通 RAG 答不了的「这份语料主要讲了什么」这类问题。
如果你只做过向量 RAG,会觉得检索就是「切块 → 嵌入 → 召回 Top-K → 拼上下文」。这套流程在「某份文档里写了什么」的局部问题上很管用,但一遇到全局性问题就露馅。微软在论文《 From Local to Global: A Graph RAG Approach to Query-Focused Summarization 》(arXiv:2404.16130)里把这个问题讲得很清楚,也给出了 GraphRAG 这套解法。
普通 RAG 的硬伤:它天生是个「检索器」,不是「总结器」
论文的核心判断是:RAG 在面向整个语料的全局问题上会失败,比如「这个数据集的主要主题是什么?」——因为这本质上是一个「查询聚焦摘要(QFS)」任务,而不是显式检索任务。
原因不难理解。向量检索的假设是「答案包含在少数几段文本里」,于是召回 Top-K 就够了。但「主要主题是什么」这种问题的答案分散在全部文本中,没有任何单一段落包含它。你召回的 K 段文本越大,越只是语料的一小块切片,模型看到的永远是局部。
而传统的 QFS 方法(把全文丢进去总结)又扛不住 RAG 系统常见的语料规模——百万 token 级别直接超出上下文窗口。两头都不行,这就是 GraphRAG 要填的缝。
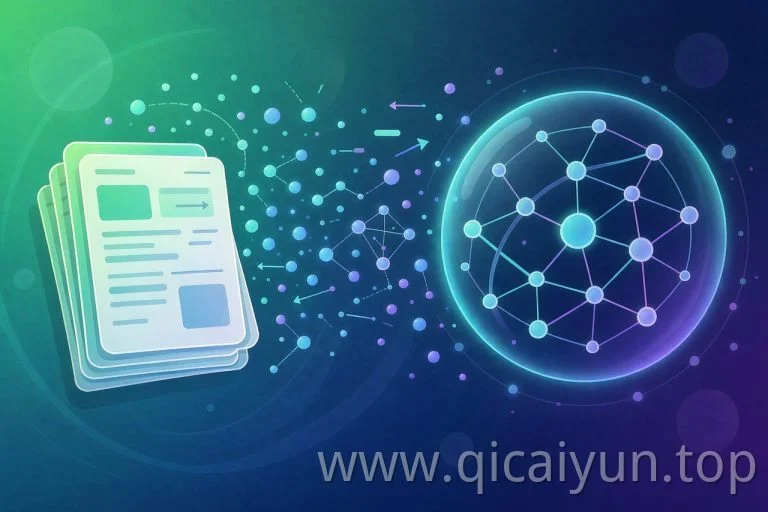
GraphRAG 的两阶段:索引建图,查询做 map-reduce
阶段一:图索引(离线)
- 源文档 → 文本块:和常规 RAG 一样先切块。
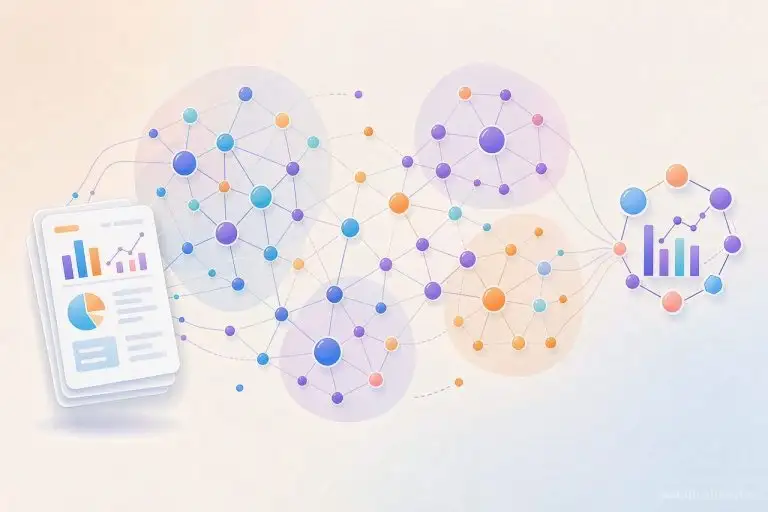
- 文本块 → 实体与关系:用大模型从每个块里抽取实体(人、组织、地点、事件等)及它们之间的关系,形成知识图谱。
- 知识图谱 → 图社区:用社区发现算法(论文用的是 Leiden 算法)把图谱划分为层次化的社区,即紧密相关的实体簇。
- 图社区 → 社区摘要:为每个社区用大模型生成摘要,且按层级自底向上生成——高层摘要吸收低层摘要的内容。 C0 是最高层(根级),C1 、 C2 、 C3 逐级变细。
阶段二:查询应答(在线)
- 社区摘要 → 社区答案:拿到问题后,并行地让每个相关社区基于自己的摘要生成一份部分回答(map 步骤)。
- 社区答案 → 全局答案:把所有部分回答再交给大模型汇总,产出最终的综合回答(reduce 步骤)。
这个 map-reduce 结构正是它能处理全局问题的关键:每个社区都贡献一票,谁都不会被漏掉,而向量 RAG 的 Top-K 天然会漏掉大部分内容。
为什么分层社区这么重要?
效果到底提升多少:论文给的实测数据
论文在两个真实数据集上做了评估:播客转录文本(约 100 万 token)和新闻文章基准集(2013 年 9 月至 2023 年 12 月,约 170 万 token)。评估用 LLM 作为裁判,对比 GraphRAG 与传统向量 RAG 基线(SS):
| 指标 | GraphRAG 胜率 | 说明 |
|---|---|---|
| 全面性(Comprehensiveness) | 72% – 83% | 答案覆盖的信息面 |
| 多样性(Diversity) | 62% – 82% | 答案视角的丰富程度 |
| Token 消耗(用 C0 摘要) | 最高省 97% | 相对直接总结原文的 TS 方法 |
结论很明确:在全局理解类问题上,GraphRAG 相对于常规 RAG 基线有实质性提升,尤其是在全面性和多样性两个维度。
和向量 RAG 的对比:什么时候该上哪个
| 维度 | 向量 RAG | GraphRAG |
|---|---|---|
| 索引成本 | 低,嵌入即可 | 高,需 LLM 抽实体 + 建图 + 生成社区摘要 |
| 擅长问题 | 局部事实查询、精确定位 | 全局主题、趋势、跨文档关联 |
| 查询成本 | 低 | 取决于社区层级,C0 极低、 C3 较高 |
| 语料变动 | 增量友好 | 改一处可能要重建社区与摘要 |
| 可解释性 | 给段落,难看关联 | 给实体关系,能追溯推理链 |
所以不要把它当替代品,它是补充。生产环境里更现实的形态是混合:局部问题走向量检索,全局问题走社区摘要路由。
落地步骤:从 0 到能跑
- 界定问题类型:先统计你的真实问题里有多少属于全局理解类。如果九成都是精确事实查询,GraphRAG 的索引成本不值得付。
- 切块并抽取实体关系:用大模型逐块抽取实体与关系,显式定义你要的实体类型(如人物、组织、产品、事件),类型越聚焦图谱越干净。
- 合并同义实体:把「腾讯」「 Tencent 」「腾讯科技」归一,这一步不做,图谱会碎成孤岛,社区发现直接失效。
- 跑社区发现并分层:用 Leiden 算法切分社区,生成 C0 到 C3 的层级摘要,自底向上汇总。
- 设计查询路由:短问题走向量检索,含「总体、趋势、主要、有哪些主题」等信号词的问题走社区摘要 map-reduce 。
- 建评测集:全局问题没有标准答案,用 LLM-as-judge 从全面性、多样性两个维度做 A/B 对比,别只看人工感觉。
成本怎么估:一个粗略的心算方法
索引阶段的大头是「让 LLM 读一遍全部语料抽实体」加上「为每个社区写摘要」。粗算规则:
- 抽取阶段:语料 token 数 × 1(基本等于把语料完整过一遍)
- 摘要阶段:社区数量 × 平均摘要长度,层级越细社区越多,成本越高
- 查询阶段:C0 只加载根级摘要,成本接近普通单次请求;C3 要读大量低层社区摘要,成本可高出数倍
因此真正的成本权衡点在「查询频率」:如果同一个语料要被问上千次,把读全文的成本一次性摊进索引非常划算;如果只问几次,直接长上下文总结反而更省。
近期演进方向
原始 GraphRAG 的社区摘要是与查询无关的预生成,这在后续研究里被认为是主要短板。已有的改进方向包括:
- FG-RAG:用上下文感知的实体扩展提升检索覆盖率,并引入查询级细粒度摘要,让摘要本身带上查询意识
- QCG-RAG:以查询为中心的图谱构建,用 Doc2Query 生成查询节点,实现粒度可控的索引与多跳检索
- HyGRAG:混合块节点与实体节点的层次图谱,并支持动态语料的增量更新(只做局部重摘要)
共同指向一个问题:预生成的粗粒度摘要不够「懂」当前这个具体问题。这也解释了为什么工业界大多是「 GraphRAG 负责召回候选,向量检索或重排负责精度」的组合拳。
GraphRAG 一定要用图数据库吗?
GraphRAG 能替代向量 RAG 吗?
索引成本大概有多高?
社区层级 C0 到 C3 该怎么选?
为什么全局问题要用 LLM 当裁判评测?
相关阅读
- RAG 与向量数据库入门:检索增强生成怎么搭——先理解向量 RAG,再看 GraphRAG 补了哪一块
- RAG 文档切块怎么做:分块策略与实践——GraphRAG 的实体抽取质量直接受切块影响
- 文本嵌入模型怎么选:选型维度与实测对比——局部检索这一环仍然要靠嵌入模型
- Agentic RAG 实战:让智能体自主决定检索策略——查询路由的自动化思路
- 智能体知识库怎么持续维护——语料更新时图谱与摘要的重建策略
评论 (0)