一句话结论
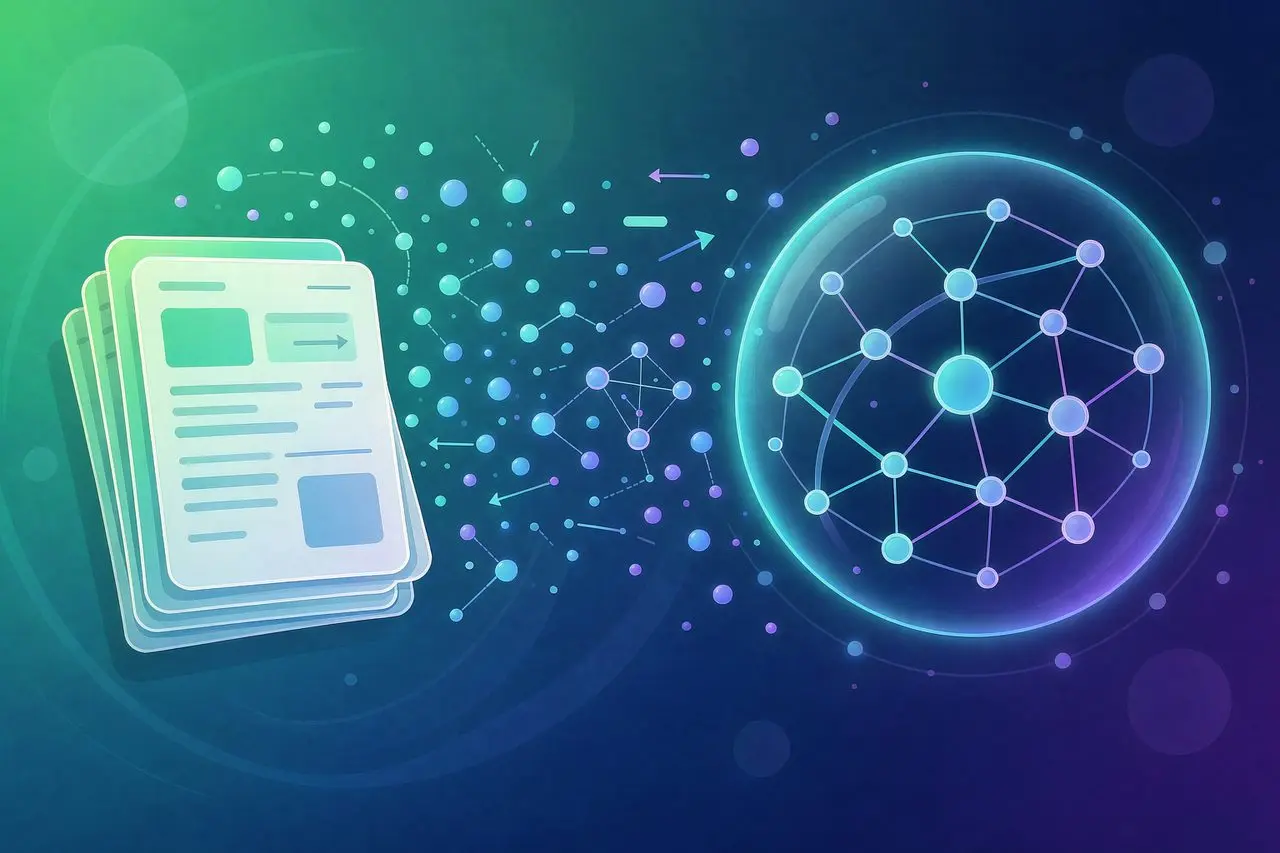
RAG(检索增强生成,Retrieval-Augmented Generation)是给大模型外接一个”知识库”的技术——先把文档切成片段并转成向量存进向量数据库,回答问题时先检索最相关片段,再让模型基于这些片段生成答案,从而显著降低幻觉、让答案可追溯、且无需重新训练模型就能更新知识。
为什么需要 RAG
大模型天生有两个短板:训练数据有截止日期、私有文档它看不到;参数化记忆容易”一本正经地编”。 RAG 用”检索 + 生成”的组合补上这两块:
| 方案 | 更新知识 | 私有数据 | 成本/门槛 |
|---|---|---|---|
| 纯大模型 | 要重新训练/微调 | 看不到 | 高 |
| 微调 Fine-tuning | 重训模型 | 可注入 | 高、易过拟合 |
| RAG | 改索引即可 | 可接入 | 中、见效快 |
所以”知识经常变、又要答得准”的场景,RAG 几乎是第一选择。
RAG 的标准工作流
- 检索(Retrieval):把用户问题转成向量,在向量库里找最相近的文档片段;
- 增强(Augmentation):把检索到的片段拼回问题,扩充上下文;
- 生成(Generation):模型基于”问题 + 检索片段”产出答案,并尽量给出来源。
RAG 的精髓是”先找资料再开口”。它让模型从”凭记忆答”变成”带着证据答”,这正是降低幻觉的关键。
搭一个最小 RAG 的四个关键环节
1. 文档分块(Chunking)
切块太大噪声多、太小丢上下文。经验值:每块 500-1000 字符、重叠 100-200 字符,保证语义连续。代码见下。
2. 向量化(Embedding)
用嵌入模型把文本转成高维向量。中文场景可选 BAAI/bge 系列;OpenAI 系可用 text-embedding-3-small,便宜够用。
3. 向量数据库选型
| 方案 | 部署 | 适用规模 | 特点 |
|---|---|---|---|
| pgvector | PostgreSQL 插件 | 中小 | 复用现有库、事务一致 |
| Milvus | 独立服务 | 超大 | 云原生、高吞吐 |
| Weaviate | 独立服务 | 中-大 | 内置混合检索 |
| Pinecone | 全托管云 | 弹性 | 免运维、按量 |
| FAISS | 本地库 | 原型 | 轻量、无服务 |
4. 检索与重排
先多召回(如 30 条),再用交叉编码器(如 ColBERTv2 / RAGatouille)重排取 Top-K,能明显提升相关度。混合检索(BM25 关键词 + 向量语义)在生产环境更稳。
RAG 和微调怎么选?
要”记住新知识、改口风”→ 微调;要”随时查最新私有文档、答案可溯源”→ RAG 。现实里常两者结合:RAG 负责事实检索,微调负责行为风格。
最小可运行示例(LangChain)
import { RecursiveCharacterTextSplitter } from "langchain/text_splitter";
import { OpenAIEmbeddings } from "@langchain/openai";
import { MemoryVectorStore } from "langchain/vectorstores/memory";

// 1) 分块
const splitter = new RecursiveCharacterTextSplitter({
  chunkSize: 1000, chunkOverlap: 200,
});
// 2) 嵌入 + 入库(生产换成 pgvector / Pinecone)
const embeddings = new OpenAIEmbeddings({ modelName: "text-embedding-3-small" });
const vectorStore = await MemoryVectorStore.fromDocuments(docs, embeddings);
// 3) 检索 top-3
const retriever = vectorStore.asRetriever({ k: 3, searchType: "similarity" });- 收集 PDF / 文档,用分块器切段并去噪。
- 选嵌入模型,把所有片段写入向量数据库并建立索引。
- 用户提问时做向量检索,召回相关片段并可选重排。
- 把”片段 + 问题”塞进提示词交给大模型生成,并附上引用来源。
相关阅读
- OpenAI Agents API 实战:把智能体编排压成一次 API 调用
- 好用的 MCP 服务器推荐清单:AI 智能体必备的 8 个工具服务
- llms.txt 是什么?让 AI 直接读懂你的内容
- 网站添加 JSON-LD 结构化数据:让搜索引擎和 AI 直接读懂你
RAG 能完全消除幻觉吗?
不能百分百,但能大幅降低。前提是检索到的片段确实相关、且提示词明确要求”只基于给定上下文回答”。垃圾进、垃圾出,检索质量决定下限。
向量数据库一定要单独部署吗?
不一定。小规模可用 FAISS 本地跑;已有 PostgreSQL 的直接上 pgvector 最省事;要弹性扩容再考虑 Pinecone / Milvus 。
中文文档 embedding 选哪个模型?
BAAI 的 bge 系列(如 bge-small-zh / bge-large-zh)中文表现优秀且可本地部署;追求简单也可用 OpenAI text-embedding-3 系列。
RAG 和 MCP 是什么关系?
RAG 解决”模型如何获得知识”,MCP 解决”模型如何调用工具/外部系统”。一个补知识、一个补能力,常在同一智能体里配合使用,见 MCP Server 搭建教程。





评论 (0)