多模态大模型(Vision-Language Model,VLM)是指能同时处理图像和文本的模型:你丢一张图进去,它能描述内容、回答关于图的问题、甚至按图写代码。它不再是图片分类器,而是把视觉信号接进了会思考的语言模型。本文从原理到落地,讲清 VLM 怎么用、用在哪、要注意什么。
VLM 的基本架构
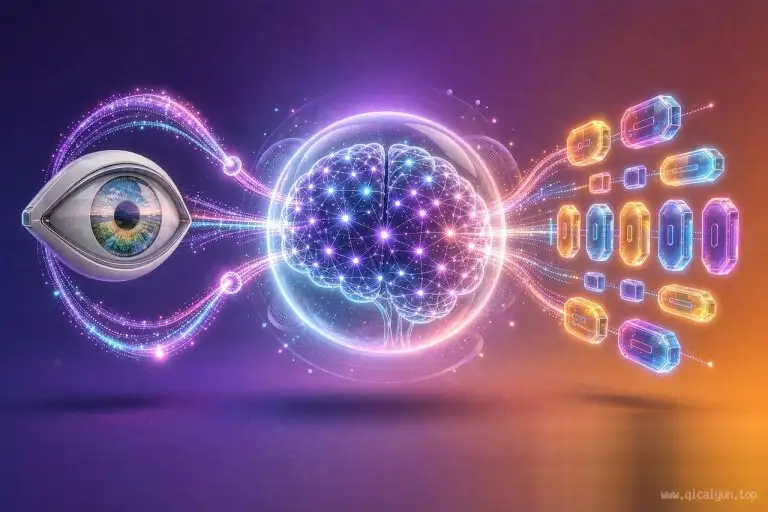
主流做法是视觉编码器、投影层、大语言模型三段式。视觉编码器(如 ViT)把图片切成块、压成一系列视觉 token;投影层把这些 token 映射进语言模型的词嵌入空间;最后语言模型把视觉 token 和文本 token 拼在一起自回归生成答案。简单说,图片被翻译成了语言模型能读懂的记号,于是它既能看图也能聊图。
典型用法场景
- 图像问答与描述:上传截图、图表、商品图,直接问这张图讲了什么、按钮在哪。
- 文档与表格理解:把扫描件、发票、报表当图喂进去,让它抽取结构化字段。
- 按图生成:看图写前端代码、写 Alt 文本、写社媒文案。
- 视觉检索:结合 向量数据库,用图搜图或图文混合检索。
和纯文本模型、多模态工具的区别
VLM 是模型原生能看图,而 多模态工具 是给文本智能体外接了读图能力,比如把图片转成文字再喂给模型。前者一体化、上下文连贯,后者灵活但要自己拼流程。选型时看你需要的是边看边想还是偶尔读一张图。
落地:把 VLM 接进你的系统
别一上来就接生产。先用 20 个真实样本跑通,确认它真的看懂了你的图,再谈集成。下面四步能帮你少走弯路。
部署与成本注意点
VLM 比纯文本更吃算力:一张图可能展开成几百个视觉 token,上下文长度和推理成本都水涨船高。建议控制图片分辨率与预处理,只传必要页面,对高频场景用小模型或缓存结果。图片本身的压缩与格式选择,思路可参考 图片素材处理 的压图流程。
- 明确输入输出:确定要传什么图、期望什么回答,先把 20 个真实样本跑通。
- 预处理图片:统一分辨率、裁剪无关区域、控制大小,降低 token 与延迟。
- 拼提示词:用角色、任务、输出格式约束回答,需要结构化就要求 JSON 。
- 评估与降级:用人工或规则校验关键回答,异常时退回人工或纯文本流程。
“图片别原图直传”
高分辨率原图会让视觉 token 暴涨,成本和延迟都失控。先按业务需要缩到合适尺寸,必要时分块描述再汇总,性价比高得多。
常见问题
“VLM
分类模型只输出一个类别标签,VLM 能围绕图片自由对话、抽取信息、按图生成内容。前者是点状判断,后者是看图思考。
“没有
可以先用云端接口跑通逻辑,再把高频、低延迟需求迁到本地小模型。完全本地化通常仍需要一块像样的显卡来扛视觉编码。
“VLM
先确认是图片质量还是模型能力问题:模糊、遮挡、长图截断都会误导它。加预处理、约束输出格式,并对关键结果做人工或规则校验。
“多模态工具和
需要边看边想、上下文连贯选 VLM;只是偶尔读一张图、且已有成熟文本智能体,用 多模态工具 外接更灵活。
评论 (0)