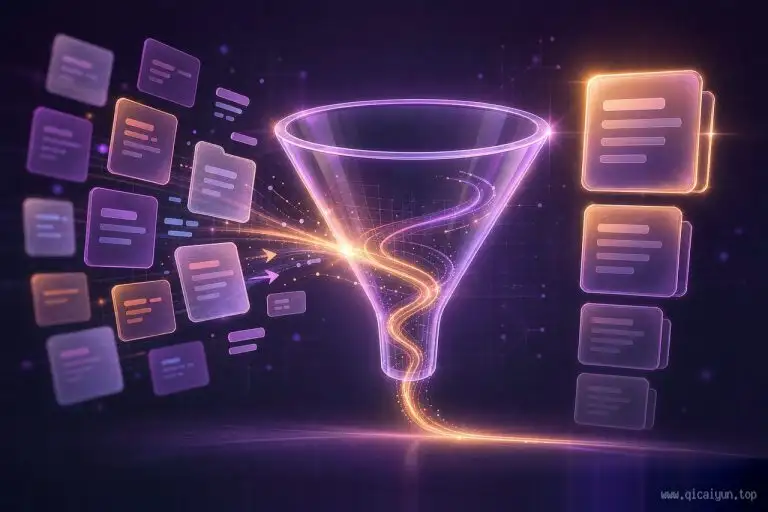
很多 RAG 系统向量检索召回一堆文档,却总把最相关的那篇排在第 5 页。问题不在向量库,而在「召回」和「精排」混为一谈。 Rerank(重排序)就是补上这最后一公里的精排环节:向量检索负责广撒网,重排序负责把真正该喂给大模型的几篇顶上来。本文讲清它为什么有效、怎么选、怎么落地。
为什么向量检索不够用
标准 RAG 检索增强生成 先靠 Embedding 把问题和文档转成向量,用余弦相似度找回最相近的几段。这种「双塔」式检索(bi-encoder)算得快、能上百万级文档,但它只能比整体语义接近度,容易漏掉关键词精确匹配、长短句不对等的情况。召回前 20 名里往往混着相关和不相关的,直接全塞给大模型既贵又乱。
Rerank 是什么:把召回结果再精排一遍
重排序用的是一个 cross-encoder 模型:把「问题 + 候选文档」拼在一起送进同一个 Transformer,让模型同时看到两边再做判断,输出一个相关性分数。因为它能看到问题和文档的交互,精度远高于只看两侧向量的双塔模型。典型流程是:向量检索召回 50–100 篇 → 重排序对这小批打分到顶 → 只取前 3–5 篇进大模型。
代价是 cross-encoder 要逐对计算,无法像向量检索那样预计算,所以只在召回的少量候选上跑,既能保精度又不拖慢整体。
“召回要宽、精排要狠”
向量检索的 top_k 可以调大(比如 50),宁可多召回;重排序再严格筛到 3–5 篇。两者分工,整体效果最好。
主流重排序模型怎么选
| 方向 | 代表 | 特点 | 适合 |
|---|---|---|---|
| 通用英文重排 | Cohere Rerank 、 BGE Re-ranker | 开箱即用、效果稳 | 快速上线、英文为主 |
| 开源可自部署 | BGE-ReRanker 、 Jina Reranker | 可本地化、数据不出域 | 隐私敏感、私有部署 |
| 多语言/中文 | BGE 多语言系列、 Jina | 中文表现好 | 中文问答、国内业务 |
| 轻量本地 | 小型 cross-encoder | 快、省资源 | 端侧或低配服务器 |
选型的隐藏前提是被重排的候选质量——这又回到 Embedding 模型选型 和 RAG 文档切分。块切得太碎或 Embedding 太弱,召回池里根本没有正确答案,重排序也救不回来。
落地时的四个注意点
- 只重排召回的小批:别对全库跑 cross-encoder,计算量会爆炸。向量检索先缩到几十篇再精排。
- 控制进模型的篇数:精排后取 top 3–5,既保相关证据完整,又不浪费上下文和 token 。
- 分数阈值要试:设一个相关性下限,低于它的直接丢弃,避免把弱相关文档硬塞进提示词。
- 和重排模型语言对齐:中文场景优先选多语言或中文重排模型,英文模型对中文打分会漂移。
- 召回扩量:把向量检索的 top_k 调到 30–50,保证正确答案进了候选池。
- 接入重排模型:选一个 cross-encoder(云端 API 或本地部署),批量接收「问题+候选」对。
- 打分排序:对每对输出相关性分数,按分从高到低重排候选。
- 截断阈值:取 top 3–5,并丢弃低于分数下限的弱相关文档。
- 回填大模型:把精排后的文档拼进提示词,评估答案质量并调参。
“别用重排替代召回”
重排序依赖一个不错的召回池,它本身不擅长从百万文档里找候选。把向量检索和重排序做成两段式,而不是二选一。
“重排序常见坑”
只跑重排不跑向量:全库 cross-encoder 太慢,生产不可行。
阈值设太高:把本该相关的文档全砍掉,答案反而变空。
中英文模型混用:用英文重排模型打中文档,分数失准,换多语言模型。
常见问题
不是。向量检索负责从海量文档里快速召回候选,重排序负责把候选精确打分排序。两者是两段式配合,重排序依赖一个质量尚可的召回池。
bi-encoder 把问题和文档分别编码后只比向量距离,看不到两者交互;cross-encoder 同时输入问题和文档,能捕捉细粒度匹配,所以精度更高,但没法预计算,只能跑在小批候选上。
常见取 top 3 到 5 篇,配合一个相关性分数下限过滤弱相关文档,既保留关键证据又控制上下文长度。
优先选多语言或中文优化的 cross-encoder,如 BGE 多语言系列、 Jina Reranker 等,避免用英文模型给中文档打分导致漂移。
评论 (0)