Playwright MCP 的核心思路:给模型无障碍树,而不是截图
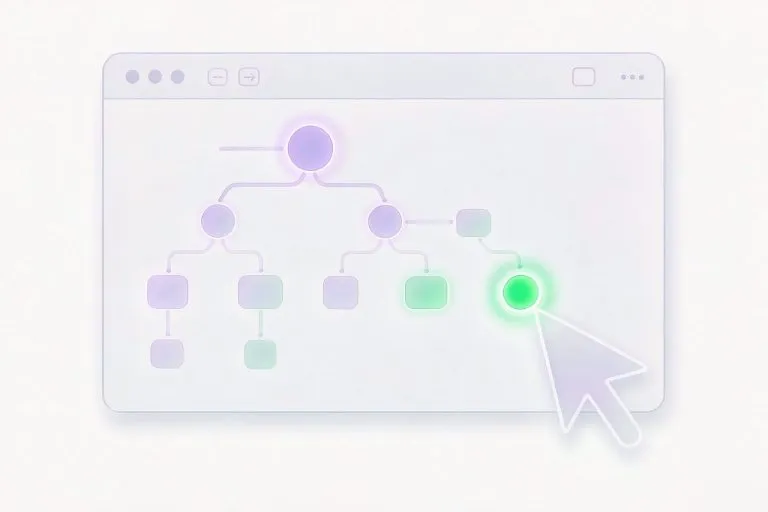
一句话结论:Playwright MCP 让智能体通过结构化的无障碍树快照操作真实浏览器——模型读 browser_snapshot 拿到带引用编号的元素树,用 ref 点击输入,全程不需要视觉模型,比截图方案更快、更稳、更省 token 。
微软官方维护的 @playwright/mcp 是目前最流行的浏览器自动化 MCP 服务器。它和”截图 + 视觉模型”方案的本质区别在于表示层:无障碍树是 YAML 风格的结构化文本,带角色、名称和稳定的引用 ID,模型据此推理,确定性远高于从像素里找按钮。
安装与基础配置
{
  "mcpServers": {
    "playwright": {
      "command": "npx",
      "args": ["@playwright/mcp@latest"]
    }
  }
}
Claude Code 用 claude mcp add playwright npx @playwright/mcp@latest 一条命令接入;VS Code 、 Cursor 、 Cline 、 Codex 等客户端都支持这个标准结构。默认启动有头浏览器(方便人眼监督),批处理场景加 --headless。
核心工具循环
日常使用就是四步循环:
- 导航:browser_navigate 打开目标 URL 。
- 快照:browser_snapshot 抓取无障碍树——这是模型的”眼睛”,每个可交互元素带唯一 ref 。
- 操作:browser_click / browser_type / browser_fill_form,参数填上一步快照里的 ref,不写 CSS 选择器。
- 验证:再抓一次快照确认状态变化;browser_console_messages 和 browser_network_requests 用来查报错和确认请求发出。
用 capabilities 控制工具面
默认只启用核心工具。按需开启额外能力组:
--caps=testing:断言工具(验证元素可见、表单值)+ locator 生成,测试工作流必开;--caps=storage:Cookie/localStorage 管理,可保存登录态复用;--caps=network:请求 mock 与离线模拟,数据提取场景用;--caps=vision:坐标点击,配合支持视觉的模型处理 canvas 类页面;--caps=devtools:trace 、录屏、操作录制生成代码。
少开工具 = 更低的 token 成本 + 更少的幻觉调用。这一点对任何 MCP 服务器都成立,官方明确把”控制工具暴露面”作为设计原则。
两个典型场景
让智能体生成测试:用自然语言描述用户流程(”登录、加购两件、结账、断言订单总额”),智能体在真实页面上走一遍,读快照发现真实选择器,产出可运行的 Playwright 测试文件——中途弹出预料之外的弹窗,它会读新快照随机应变,而不是死在过期的定位器上。
数据提取与巡检:网络工具确认 API 调用正确发出,存储工具维持登录态,配合 headless 模式做定时巡检。
另外注意官方的最新指引:对以写代码为主的高吞吐编程智能体,官方现在更推荐 CLI + Skills 方式(token 效率更高);MCP 模式更适合需要持久浏览器状态、迭代推理页面结构的场景。工具形态的选择标准同样是 token 成本。
MCP 协议本身的入门见 MCP 是什么入门教程;在 Cursor 和 VS Code 里接入的完整步骤见 MCP 客户端配置;和其他浏览器自动化方案的横向对比在 AI 浏览器自动化工具对比;另一个实战向的 MCP 案例可以看 高德地图 MCP 实战。
为什么用无障碍树而不是截图?
登录状态怎么保持?
遇到 canvas 或地图这类无语义元素怎么办?
参考来源:microsoft/playwright-mcp 官方仓库 README 、 playwright.dev/mcp 官方 Capabilities 文档。


评论 (0)