

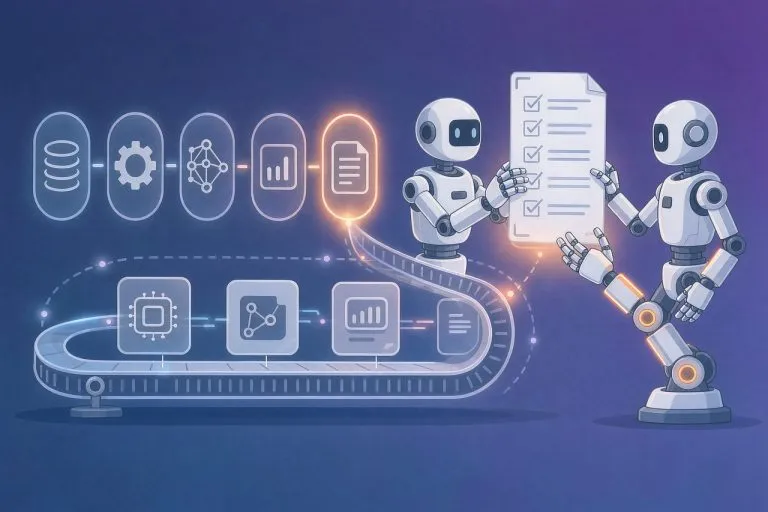
长时运行智能体跑偏的根因不是模型不够强,而是每个上下文窗口都从零开始:新会话不记得上一轮干了什么。解法是搭一层 harness——用 initializer agent 一次性铺好环境(功能清单 + 进度文件 + 首次提交),再让 coding agent 每轮只做增量推进,并在收工前把仓库留在”可以直接合并”的干净状态。
为什么长任务智能体会跑着跑着就跑偏
Anthropic 在官方工程博客里把长时运行智能体的失败归纳成两种模式,这两种模式在真实项目里几乎一定会遇到:
- 一次想做完:模型拿到”做个 XX 网站”这类高层需求后,倾向于一口气把整个应用写出来,结果在上下文窗口用尽时留下一个半成品;下一轮会话看不到任何交接说明,只能先花大量 token 猜上一轮到底做到哪。
- 过早宣布完工:项目过半后,新起的 agent 实例环顾四周发现”已经有不少功能了”,就直接判定任务完成,剩下的需求被静默丢弃。
注意:这两个问题不会因为压缩(compaction)而自动消失。压缩只解决”窗口塞不下”,不解决”不知道该干什么”。
压缩与接力是两件事
| 能力 | 解决的问题 | 不解决的问题 |
|---|---|---|
| 上下文压缩(compaction) | 对话太长塞不进窗口 | 摘要丢细节、不知道下一步目标 |
| 结构化笔记 / 记忆文件 | 跨会话保留关键事实 | 进度文件没人维护就等于没有 |
| Initializer + 增量 harness | 每轮都从明确的当前状态出发 | 需要你先写好功能清单 |
双阶段 harness:Initializer + Coding Agent
核心思路是把”第一次运行”和”后续每次运行”用两套不同的提示词分开。
- 让 initializer agent 写功能清单:给它原始需求,要求它输出一份展开后的功能列表(细到”用户可以点新建对话、输入问题、回车、看到回复”这种粒度),而不是让它直接写代码。
- 生成 init.sh:由 initializer 写出环境初始化脚本,保证任何新会话都能一键把项目跑起来。
- 建立 claude-progress.txt:约定好每个会话结束前必须往这个文件追加”本轮做了什么 / 还剩什么 / 已知问题”。
- 做一次初始 git 提交:让第一轮产出成为可回溯的基线,后续每轮都在它之上增量提交。
- coding agent 每轮只推进一小步:提示词明确要求”一次只做一个功能,做完必须自测通过并提交,收工时仓库状态要能直接合并到主分支”。
进度文件怎么写才有用
进度文件不是流水账日志。它只服务一个目的:让一个完全没有记忆的新 agent 在三分钟内搞清楚现状。所以每轮结束时只写三类信息:
- 已完成:功能清单里哪些条目已经通过验证(写编号,不写形容词)。
- 进行中:当前正在做的条目、卡在哪、试过什么方案。
- 已知缺陷:还没修的问题,避免下一轮把它当成新 bug 重复排查。
把”当前任务目标 + 验收标准 + 已读改的文件路径 + 测试结果”写进项目的 CLAUDE.md 里,而不是只写在第一轮提示词里。压缩器会读 CLAUDE.md 的内容并按你的要求保留这些字段,写在首轮提示词里的指令则会在压缩后被摘要掉。
五条落地规则
- 先约束范围,再动手写代码。功能清单越细,agent 越不容易 one-shot,也不容易提前宣布完工。
- 每轮必须留下可合并状态。没有重大 bug 、代码整洁、有注释——这是硬要求,不是建议。
- 并行探索交给子智能体。子智能体用干净上下文深挖,只回传 1000–2000 token 的浓缩结论,主智能体上下文不会被污染。
- 工具按需挂载。每个工具定义都吃上下文,MCP 默认开启工具搜索(按需加载 schema),关闭或降级为全量预加载时,几个服务器就能吃掉一大截窗口。
- 常规任务降档。只读文件、列目录这类任务把 effort 设为 low,把预算留给真正需要推理的环节。
为什么压缩之后仍然需要进度文件
压缩是”对过去的摘要”,进度文件是”对未来的指引”。压缩后的摘要天然偏向叙述已经发生的事,而下一轮 agent 真正需要的是”接下来该做第 37 条功能、第 12 条有已知缺陷先别碰”。这两类信息不能互相替代。 Anthropic 的实验里,仅靠压缩的 agent 仍然会在多窗口循环中退化,加上 progress 文件 + git 历史后才稳定做出生产级应用。
常见坑
- 把进度文件写成了日志:几百行流水账反而挤占上下文。只保留三类信息,其余交给 git history 。
- 功能清单一次性生成后不再更新:需求变了清单要跟着改,否则 agent 会照着过期清单做无用功。
- 没有自测环节:每轮”做完”必须配一条可执行的验证命令,否则半成品会一路累积到无法收拾。
- 在提示词里写持久规则:会被压缩摘要掉,应该写进项目规则文件。
长时运行智能体和普通多轮对话有什么区别?
区别在于目标规模与失败代价。普通多轮对话在一两个上下文窗口内结束,状态靠对话历史就能维持;长时运行智能体的任务要横跨几十个窗口,任何一个窗口丢失状态都会让后续工作整体偏移,所以必须引入外部状态(进度文件、 git 、功能清单)作为唯一事实来源。
上下文压缩能不能替代进度文件?
不能。压缩解决的是窗口容量问题,产出的是对历史的摘要;进度文件解决的是目标连续性问题,内容是下一步该做什么。两者是互补关系,只上压缩的方案在长任务里仍会出现跑偏和提前完工。
功能清单应该多细?
细到”可独立验收”。一条功能应该能在一次会话内完成并验证,例如”用户可以提交表单并看到成功提示”,而不是”完成用户系统”。 Anthropic 的示例中,一个站点克隆需求被展开成了两百多条这样的条目。
子智能体能完全解决上下文问题吗?
不能完全解决,但能大幅缓解。子智能体把深度探索的上下文隔离在自己内部,只回传浓缩结论,主智能体的上下文只增长结论部分。适合研究、检索、代码探索这类并行任务,不适合需要频繁来回确认的对话式任务。
相关阅读
- AI Agent 记忆怎么实现:长短期记忆架构与 4 种落地方案
- 多智能体怎么编排:Lead + Subagent 架构与 5 条实战原则
- 智能体 Planning 规划模式实战:先出计划再动手
- 提示词注入怎么防:AI 智能体上线前必须做的 7 层防护


评论 (0)