

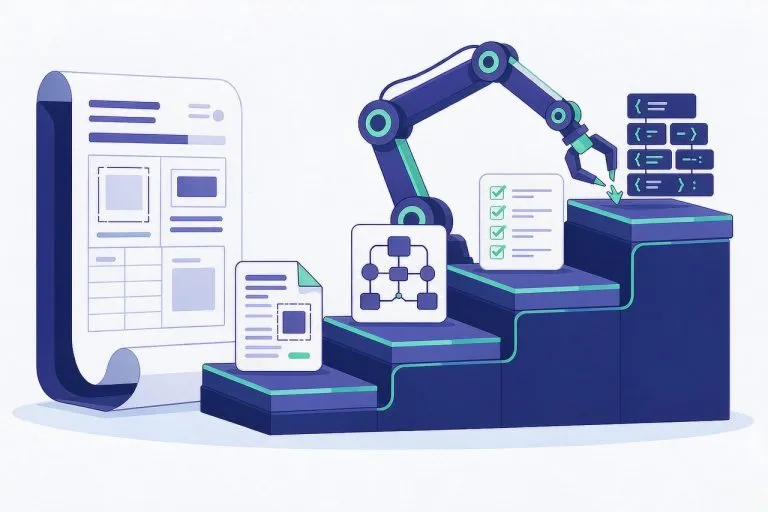
规格驱动开发(Spec-Driven Development)的核心改动只有一处:把 spec 从「写完就归档的文档」变成「驱动生成的唯一事实源」。流程是先让 AI 智能体产出规格,再由你确认规格,接着拆成可独立验证的小任务,最后才让智能体逐条实现。它解决的是 vibe coding 最典型的症状——代码看着对、跑起来不对,以及聊到后面智能体忘了当初为什么这么定。
为什么直接让 AI 写代码会飘
把编码智能体当搜索引擎用,是当下最常见的误用。你说一句「做个用户系统」,它返回一大段代码,编译也许能过,但架构未必是你想要的、边界条件多半漏了、后续几轮对话还会推翻前面已经定下的决策。 GitHub 官方博客对这种现象的总结很到位:问题不在智能体的编码能力,而在我们把它当成搜索引擎,而它其实更像一个「照字面执行的结对程序员」——擅长模式识别,但必须拿到无歧义的指令。
规格驱动就是补上这份无歧义的指令,并且让它随项目演进,而不是一次性口述。
四阶段流程:Specify → Plan → Tasks → Implement
| 阶段 | 产出 | 你要回答的问题 | 放行标准 |
|---|---|---|---|
| Specify | spec.md | 谁用?解决什么问题?成功长什么样? | 用户旅程与验收标准写清楚了 |
| Plan | plan.md | 技术栈、架构、约束、合规与性能指标 | 公司标准与外部约束都写进去了 |
| Tasks | tasks.md | 怎么切成可独立测试的小块 | 每个任务能单独实现并验证 |
| Implement | 代码 | 逐条实现并人工复核 | 改的是小而聚焦的变更,不是千行大包 |
关键约束是每个阶段都有检查点,当前阶段没验证完不进下一个。 Specify 阶段刻意不谈技术栈,只谈「做什么」和「为什么」;技术决策全部推迟到 Plan 阶段,这样规格不会一上来就被实现细节污染。
任务粒度决定成败
Tasks 阶段最容易被敷衍。「实现用户认证」不是一个任务,「创建校验邮箱格式的用户注册接口」才是。判断标准很朴素:这个任务能不能独立实现、独立测试。做到这个粒度,智能体才有自我校验的抓手,你 review 时看到的也是聚焦的小改动,而不是一次三千行的 PR 。
上手:Spec Kit 的四条命令
- 初始化项目:
uvx --from git+https://github.com/github/spec-kit.git specify init <项目名>,它会建好 spec/plan/tasks 的目录与约定。 - 执行
/specify,给一段高层描述,只讲目标用户和使用场景,让智能体生成完整 spec.md 。生成后先自己读一遍再往下走。 - 执行
/plan,把技术栈、架构、合规要求、性能指标喂进去。拿不准时可以要求它给多个方案对比。 - 执行
/tasks拿到任务清单,再逐条/implement。每条完成后跑测试,不通过就回到 spec 修正而不是改代码打补丁。
这套命令在 GitHub Copilot 、 Claude Code 、 Gemini CLI 上都能用,本质是把流程固化成可重复的提示词,不绑定某一家工具。
更进一步:把 Markdown 当源码写
一种更激进的实践是:把整个应用的行为写成一份 main.md规格,再让智能体「编译」成真正的源码。规格里连数据库表结构、循环与条件分支都用结构化 Markdown 描述,README 作为面向用户的文档被引用进规格,保证文档与实现同步。
它的循环是:改 spec → 让智能体重新编译 → 跑测试 → 不对就改 spec → 重复。好处是从不丢上下文,代价是「用自然语言把事情说清楚」本身就是 hardest part 。真要用,建议配一个 lint 提示词:统一术语(pull/get/fetch 只留一个)、删重复内容、保留全部关键细节,只优化不改语义。
规格该写成什么样
一份能让智能体稳定执行的规格,至少包含这四块:
- 目标与非目标:明确写出这次不做什么,比写做什么更能防止发散。
- 用户旅程:以步骤描述真实使用路径,而不是罗列功能点。
- 验收标准:可判定的条件,最好能量化(「 P95 小于 200 ms 」而不是「要快」)。
- 边界与异常:输入非法、依赖不可用、数据缺失时怎么办,这是智能体最容易漏的部分。
写完之后有个简单的自检:把规格给一个不了解背景的同事读,如果他能据此判断实现是否合格,就够格了;如果他还要追问,说明仍有歧义。
它和 vibe coding 不是对立关系
选型的判断标准其实就两个维度:改错的成本和背景是否需要长期保留。
- 一次性脚本、原型验证、风格探索:直接 vibe coding,写规格是浪费。
- 要合进主干、要长期维护、有合规要求的功能:必须先有规格。
- 中间地带:可以先 vibe 出一个能跑的原型,再反过来把它写成规格,让智能体按规格重写生产版本。
别把规格驱动当成流程负担,它的收益点是把返工从「读完三千行代码才发现」提前到「读两页 Markdown 就能拦住」。


评论 (0)