

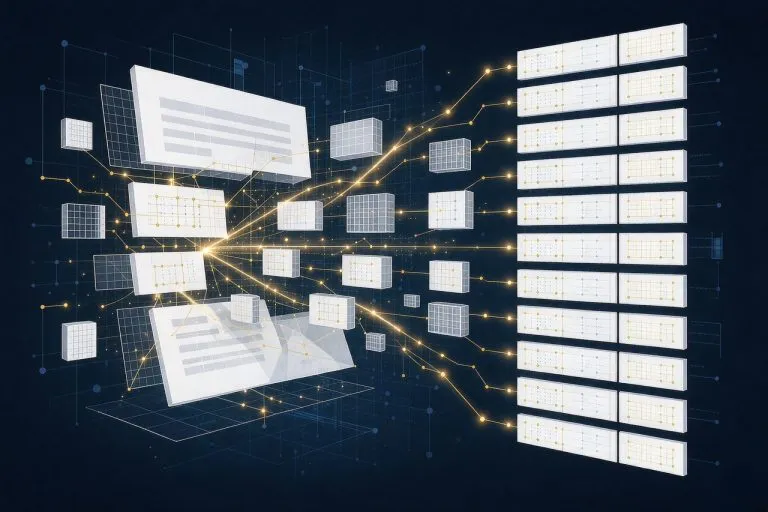
知识库效果差,八成不是向量模型选错了,而是 PDF 从一开始就没被正确解析——表格错位、多栏混排、页眉页脚污染正文,检索出来的内容本身就是破的。文档解析是 RAG 链路里最不起眼也最致命的一环。
PDF 为什么难解析
PDF 的设计目标是”在任何设备上显示一致”,不是”让机器提取数据”。它只记录字符画在哪个坐标上,没有段落、表格、阅读顺序这些语义结构。这也解释了几个典型症状:
| 文档特征 | 解析后的表现 | 对检索的影响 |
|---|---|---|
| 多栏排版 | 左右两栏文字被拼成一整段 | 语义混乱,检索命中但答非所问 |
| 合并单元格表格 | 行列错位,数值对不上表头 | 数字类问题必然答错 |
| 扫描件 | 没有文本层,全靠 OCR | 识别噪声直接进入知识库 |
| 页眉页脚 | 每页重复”第 N 页 / 公司名” | 污染向量,稀释有效信息 |
| 图表与公式 | 信息根本不在文本里 | 这部分知识完全检索不到 |
选解析工具时不要看”OCR 准确率”这一个数字。真正拉开差距的是表格还原和阅读顺序还原,这两项直接决定问答能不能答对。
三条技术路线怎么选
目前市面上的方案可以归成三类,选型本质是”成本、可控性、准确率”三选二:
- 商业文档服务:云厂商的文档智能服务,开箱即用、语言覆盖广、表单类文档准,按页计费,适合有稳定预算、文档以表单发票为主的场景。
- 专用解析工具:这类工具专门为 RAG 设计,输出的是干净的 Markdown 或结构化数据,能还原表格和阅读顺序,多数同时提供云端接口和本地部署。
- 开源解析库:免费、可私有化、数据不出内网,但对硬件有要求,复杂版式需要自己调参,适合有合规要求或有 GPU 的团队。
四类典型场景的选型建议
- 合同、发票、表单:优先选带预训练模板的商业服务,字段抽取准确度最高,省去自己标注的成本。
- 技术文档、论文、手册:优先选能还原公式与表格结构的解析工具,输出保留层级的 Markdown,便于后续分块。
- 扫描档案、手写材料:需要带 OCR 能力的方案,重点关注多语言支持与倾斜矫正,输出后必须做一次人工抽检。
- 含图表的数据报告:需要能给图表生成文字描述的方案,否则图表信息在检索时等于不存在。
评估别只看厂商给的分数
各家的基准分数口径不一,横向比较意义有限。真正可信的做法是拿自己的 20 份文档做小样本测试:
- 挑 20 份覆盖各种难度的真实文档,人工标注出每份里的关键字段和表格数值。
- 让候选工具各跑一遍,比对字段抽取正确率、表格行列是否对齐、阅读顺序是否正确。
- 记录单页耗时与单页成本,乘上月度文档量,得到真实开销。
如果只能看一个指标,就看表格准确率。文本抽取各家差距不大,表格才是分水岭。
和 RAG 后续环节的衔接
解析只是第一步,输出的结构化 Markdown 还要经过合理的切分才能进向量库。切分策略建议按标题层级优先、长度兜底,具体做法参考文档分块的实战方法。
切完之后是向量化,模型选型要和数据语言、维度成本一起考虑,判断维度在文本嵌入模型怎么选里有详细拆解。如果还在搭检索层,可以先看向量数据库入门再决定存储方案。
上线前必做的一道保险
解析结果的三项校验
- 随机抽 10 页人工比对原文,统计字符级错误率,超过 2% 就要换方案或加后处理。
- 把所有表格单独导出,检查表头与数值是否对得上,这是最容易静默出错的部分。
- 在解析结果里搜索页眉页脚的重复字符串,确认已被清理,否则会污染检索。
先用 OCR 再交给大模型整理可以吗?
可以,但成本高且慢。更好的做法是让解析工具直接输出结构化的 Markdown,大模型只负责语义层面的补齐,不参与版面还原。
开源方案能追平商业服务吗?
在通用文档上差距已经很小,甚至在表格还原上常有开源方案超过商业服务的案例;差距主要在极端版式、超大批量吞吐和免运维上。
扫描件必须单独走 OCR 吗?
取决于解析工具是否内置 OCR 。多数现代解析工具已经把扫描件作为普通输入处理,无需单独加一步,但要确认它支持你需要的语言。
解析一次的成本怎么估?
用单页价格乘月度页数,再加上 GPU 或人工复核的成本。多数团队低估的是复核成本,而不是解析本身的费用。


评论 (0)